CIRAD · stage 2026 · système agentique pour graphe génomique
GenomInt
Interroger un graphe génomique sans écrire de Cypher.
Sur Ganoderma, GenomInt combine dialogue et exploration du graphe. J’ai développé l’agent et le backend de l’explorateur : requêtes Neo4j et API.
En bref
- Cadre
- Stage CIRAD · UMR AGAP · avril–août 2026
- Ma part
- Agent Pi · backend de l’explorateur (requêtes Neo4j et API) · sécurité et déploiement
- Équipe
- Encadrement : Létizia Camus-Kulandaivelu · interface : Théodore de Boisseson
- Suite
- Code fermé · publication scientifique en préparation (co-auteur)
Contexte et périmètre
Le graphe Neo4j relie génomes, pangènes, transcrits et annotations pour étudier la pathogénie de Ganoderma. L’enjeu : rendre ces données interrogeables par les biologistes.
Périmètre personnel
J’ai développé l’agent et le backend du GKG Explorer : requêtes Neo4j, API, parcours et exports. J’ai aussi travaillé sur la sécurité et le déploiement. Théodore de Boisseson a porté l’interface ; nous avons partagé les contrats d’API et l’intégration.
L’interface en images
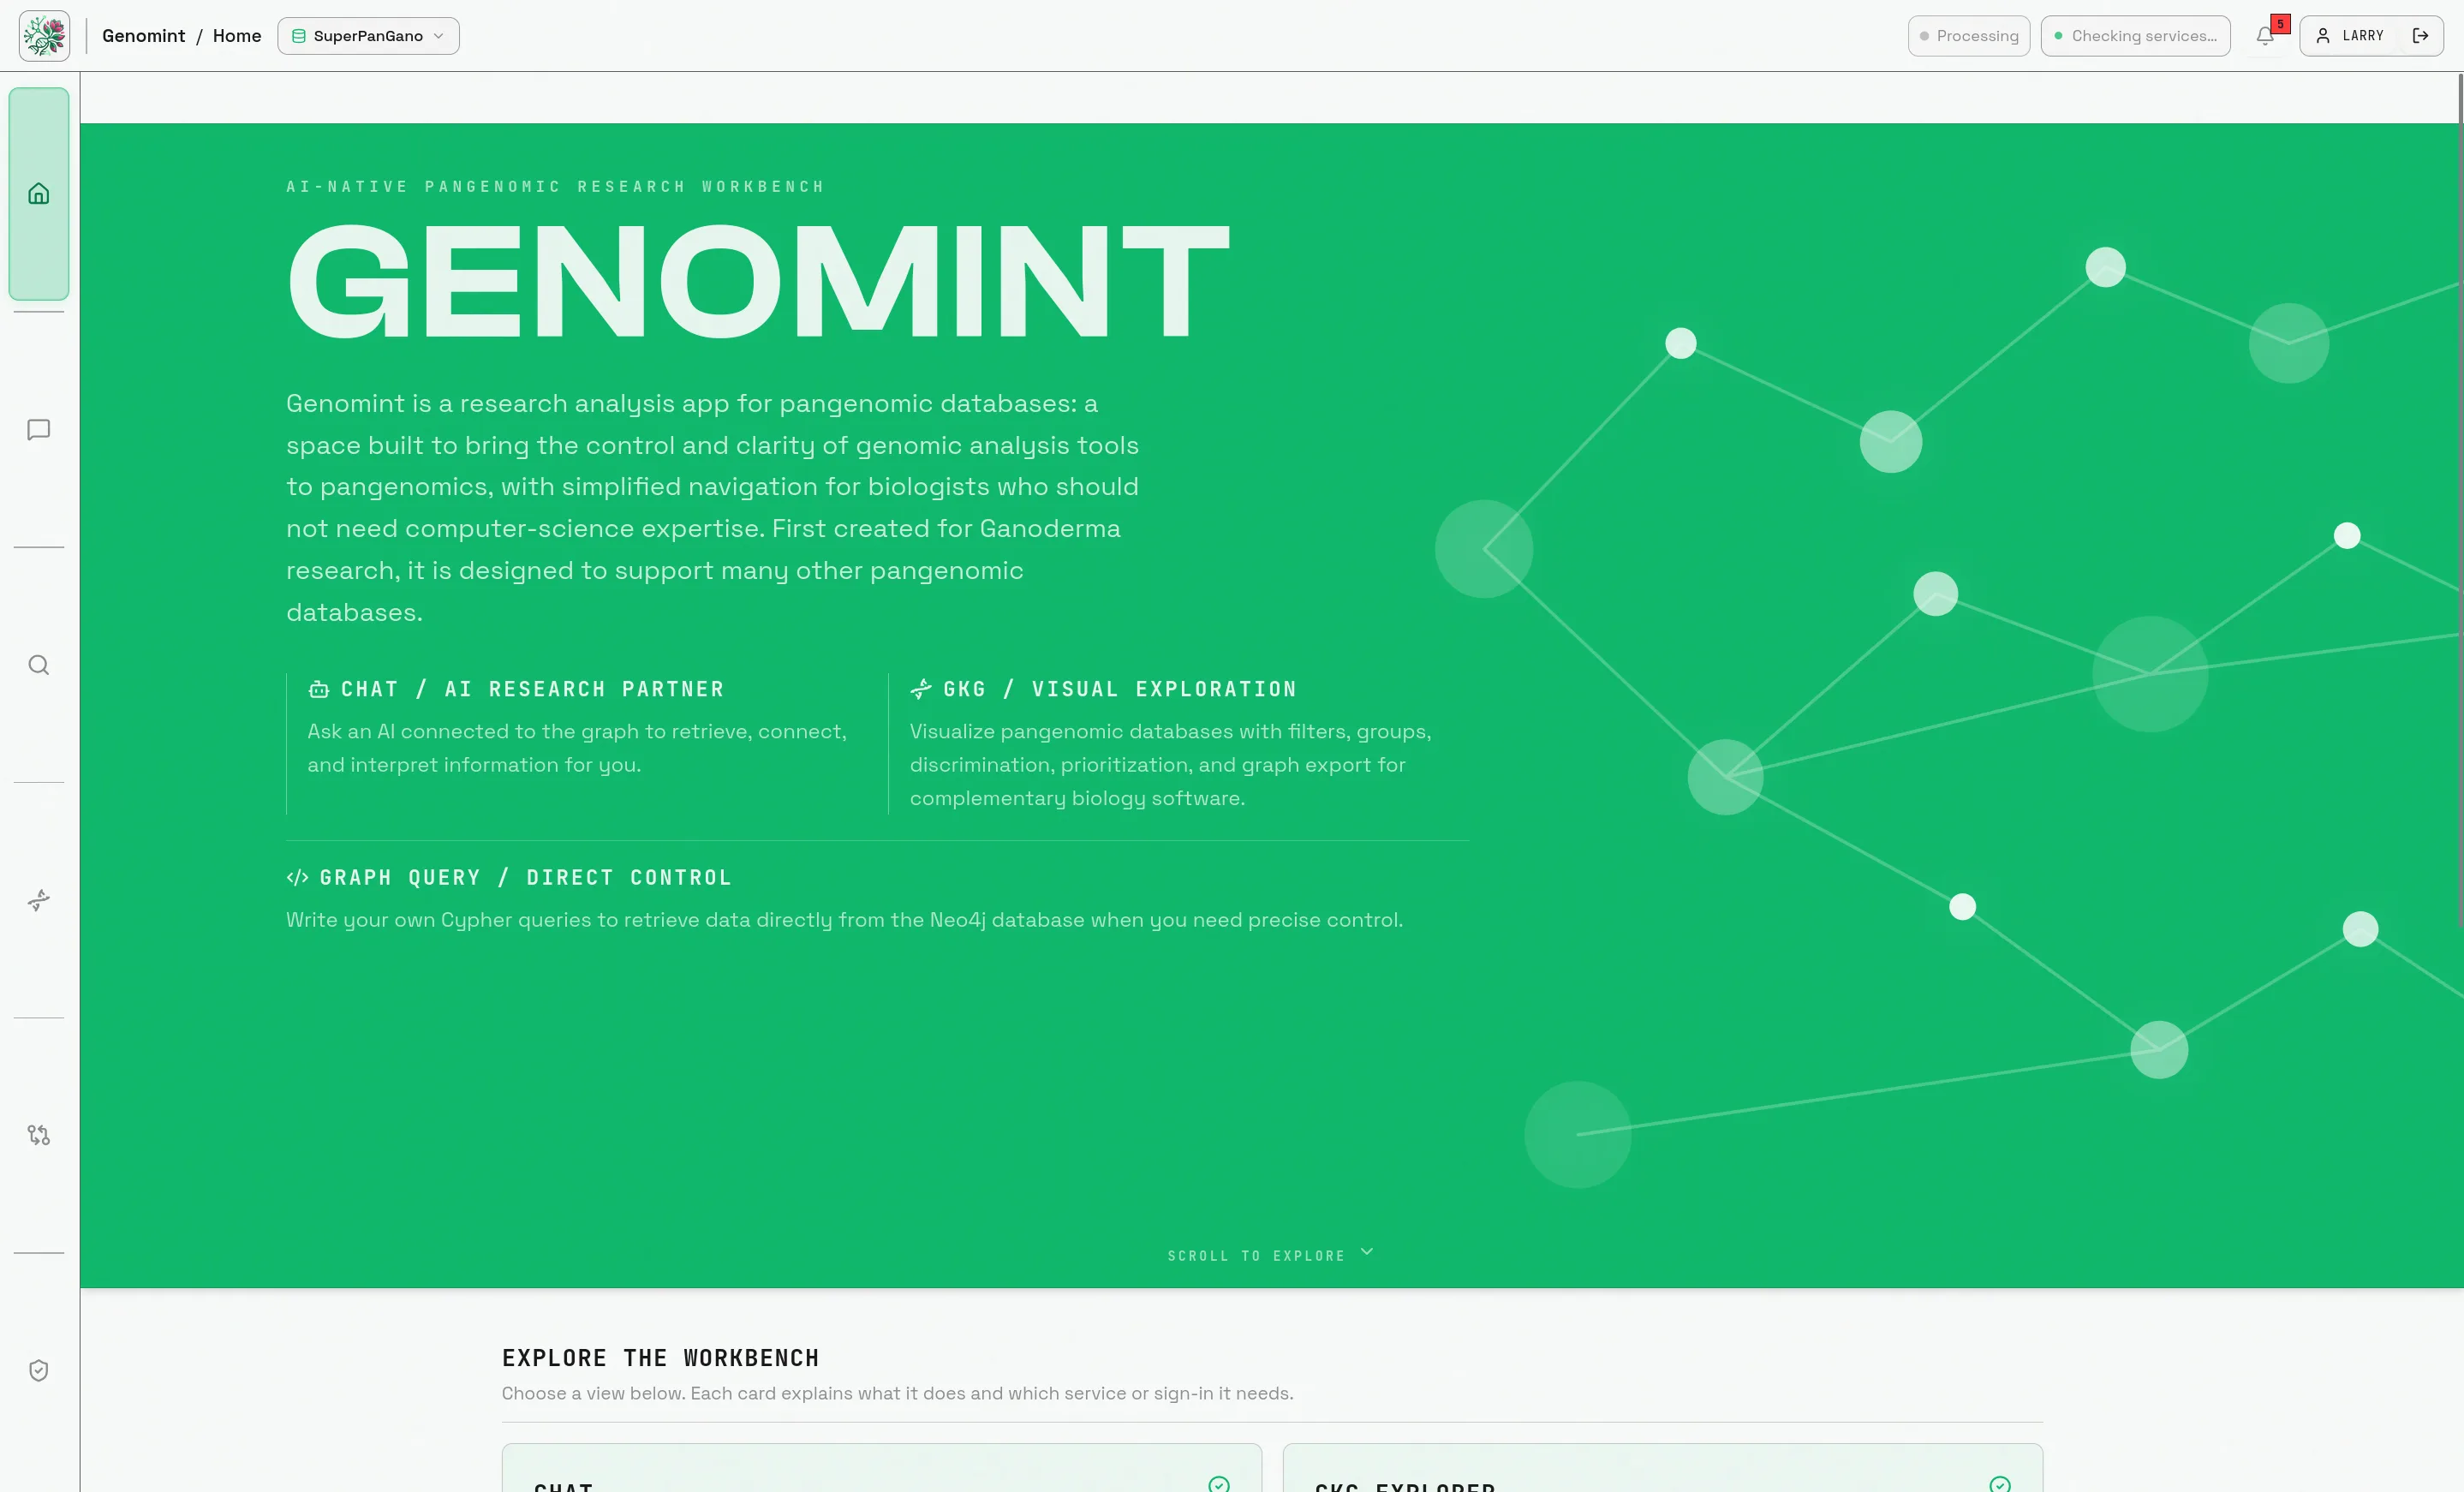
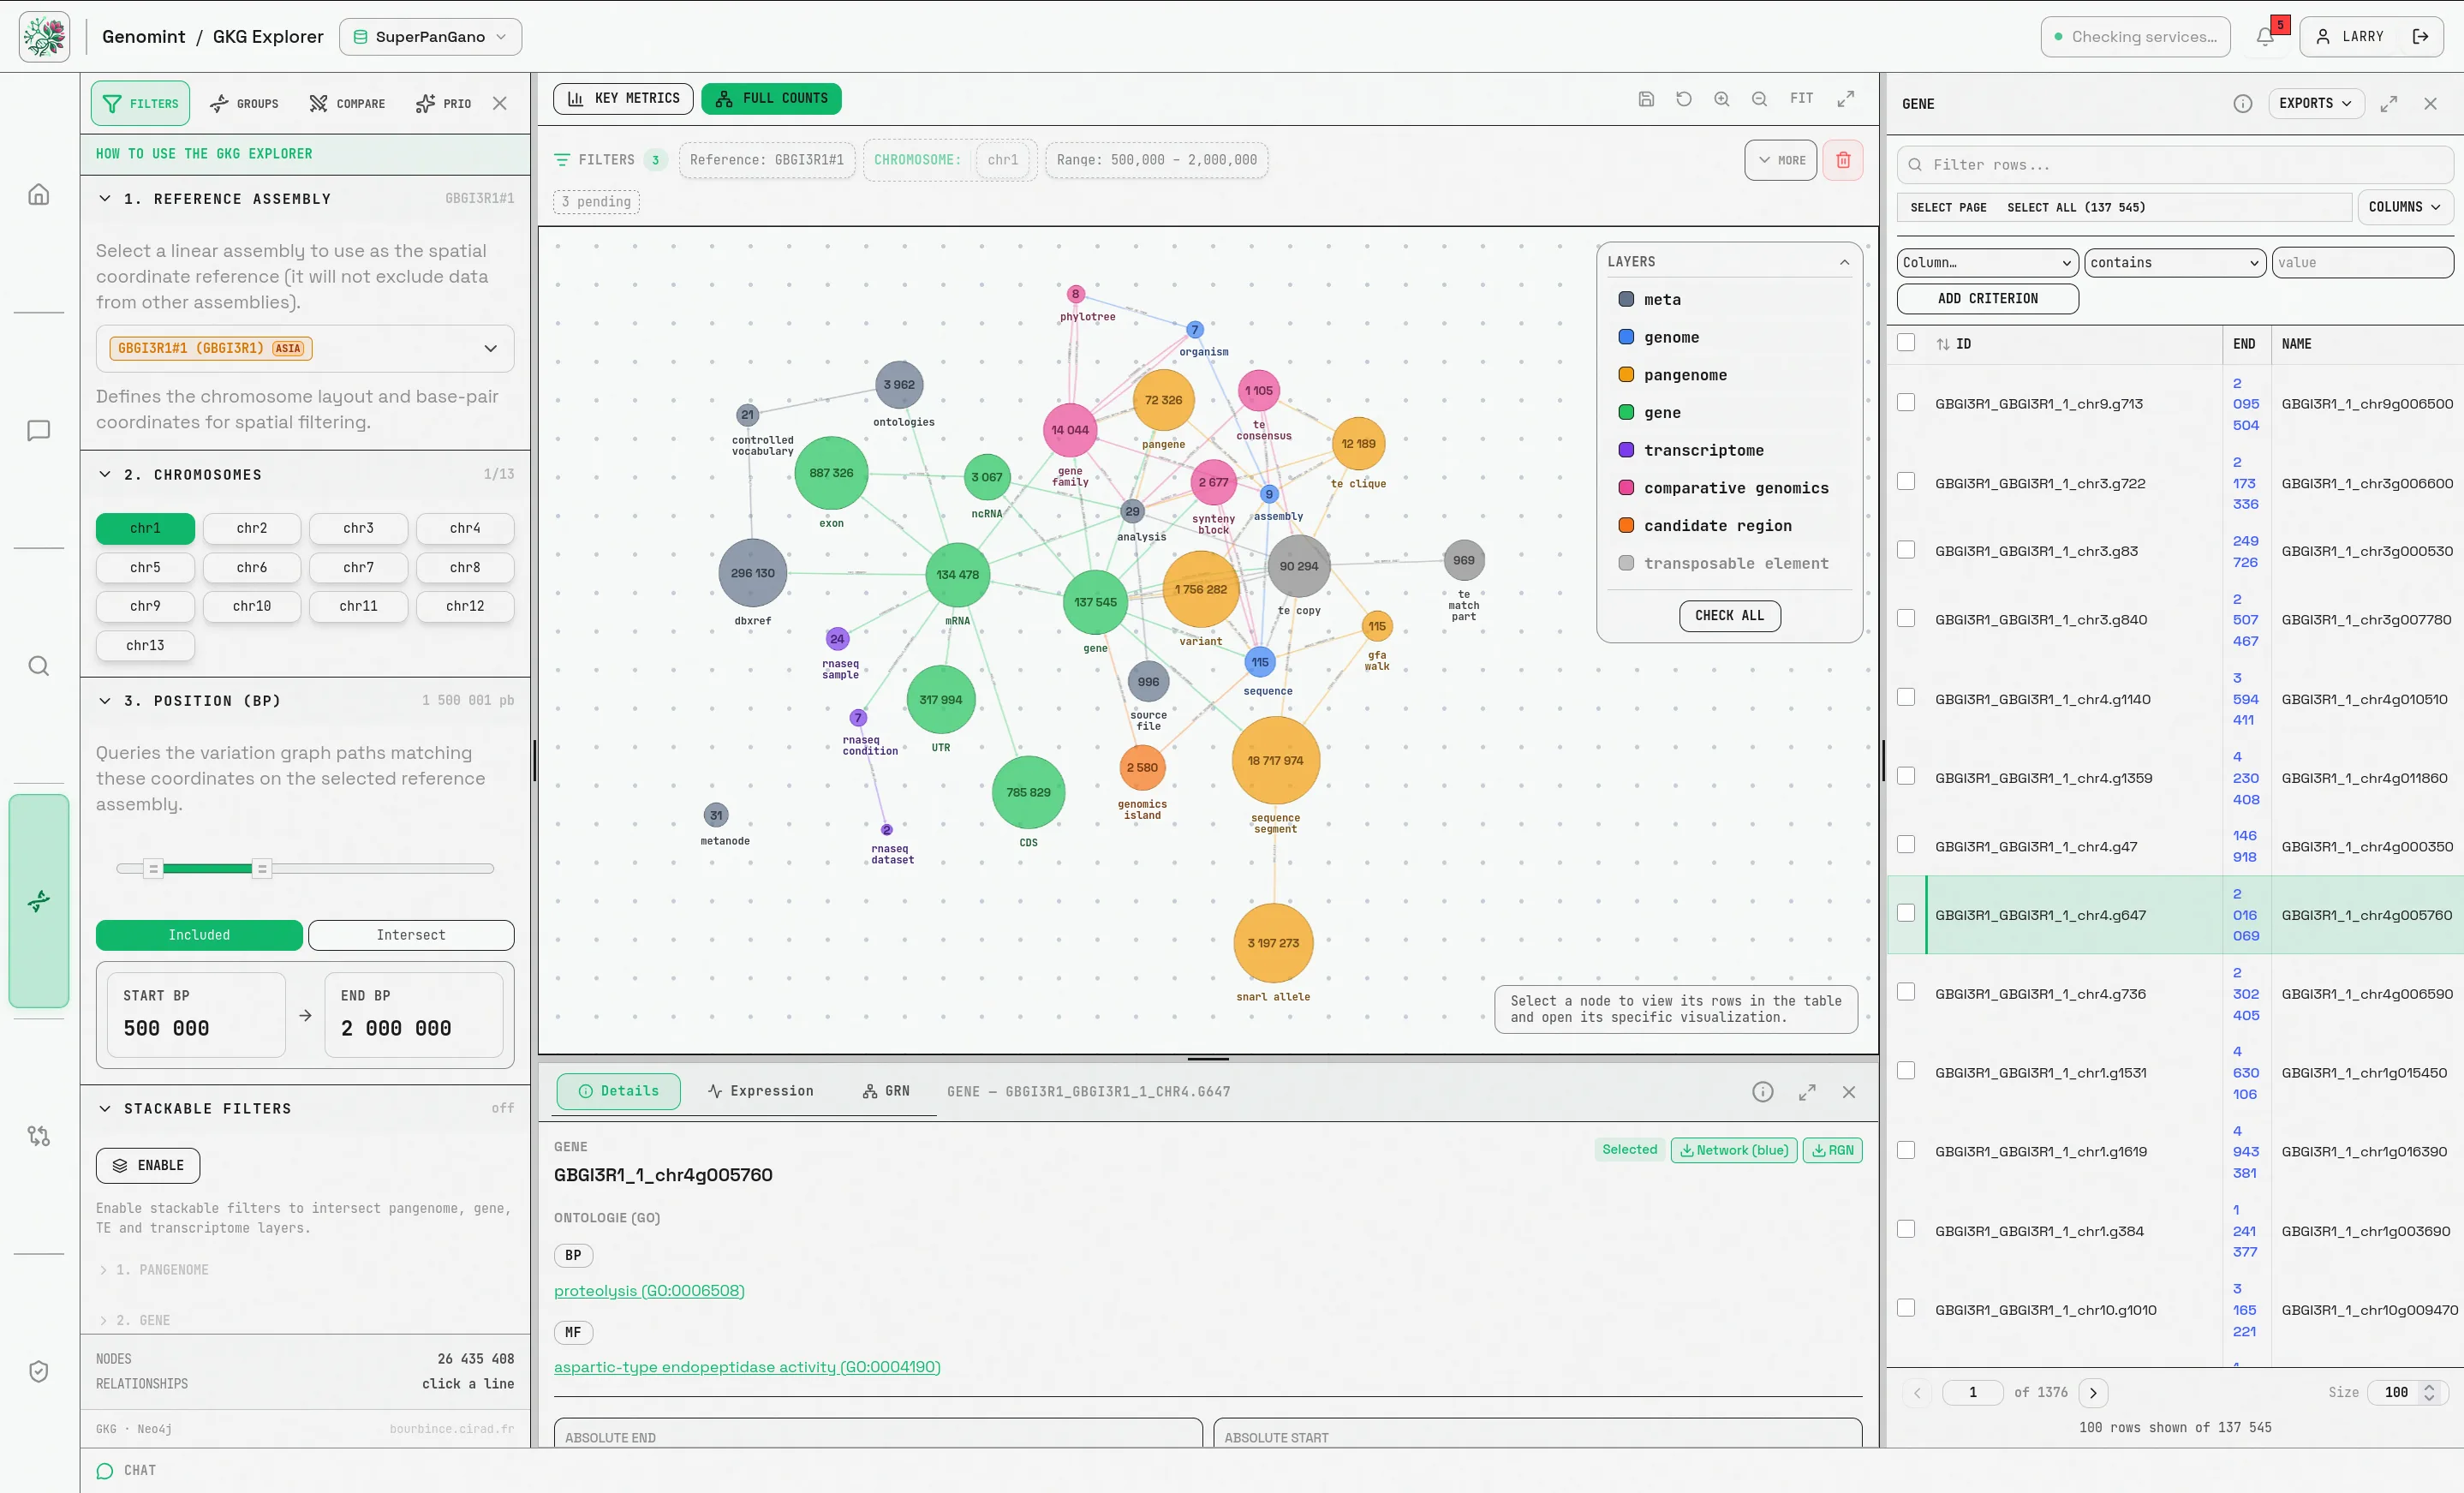
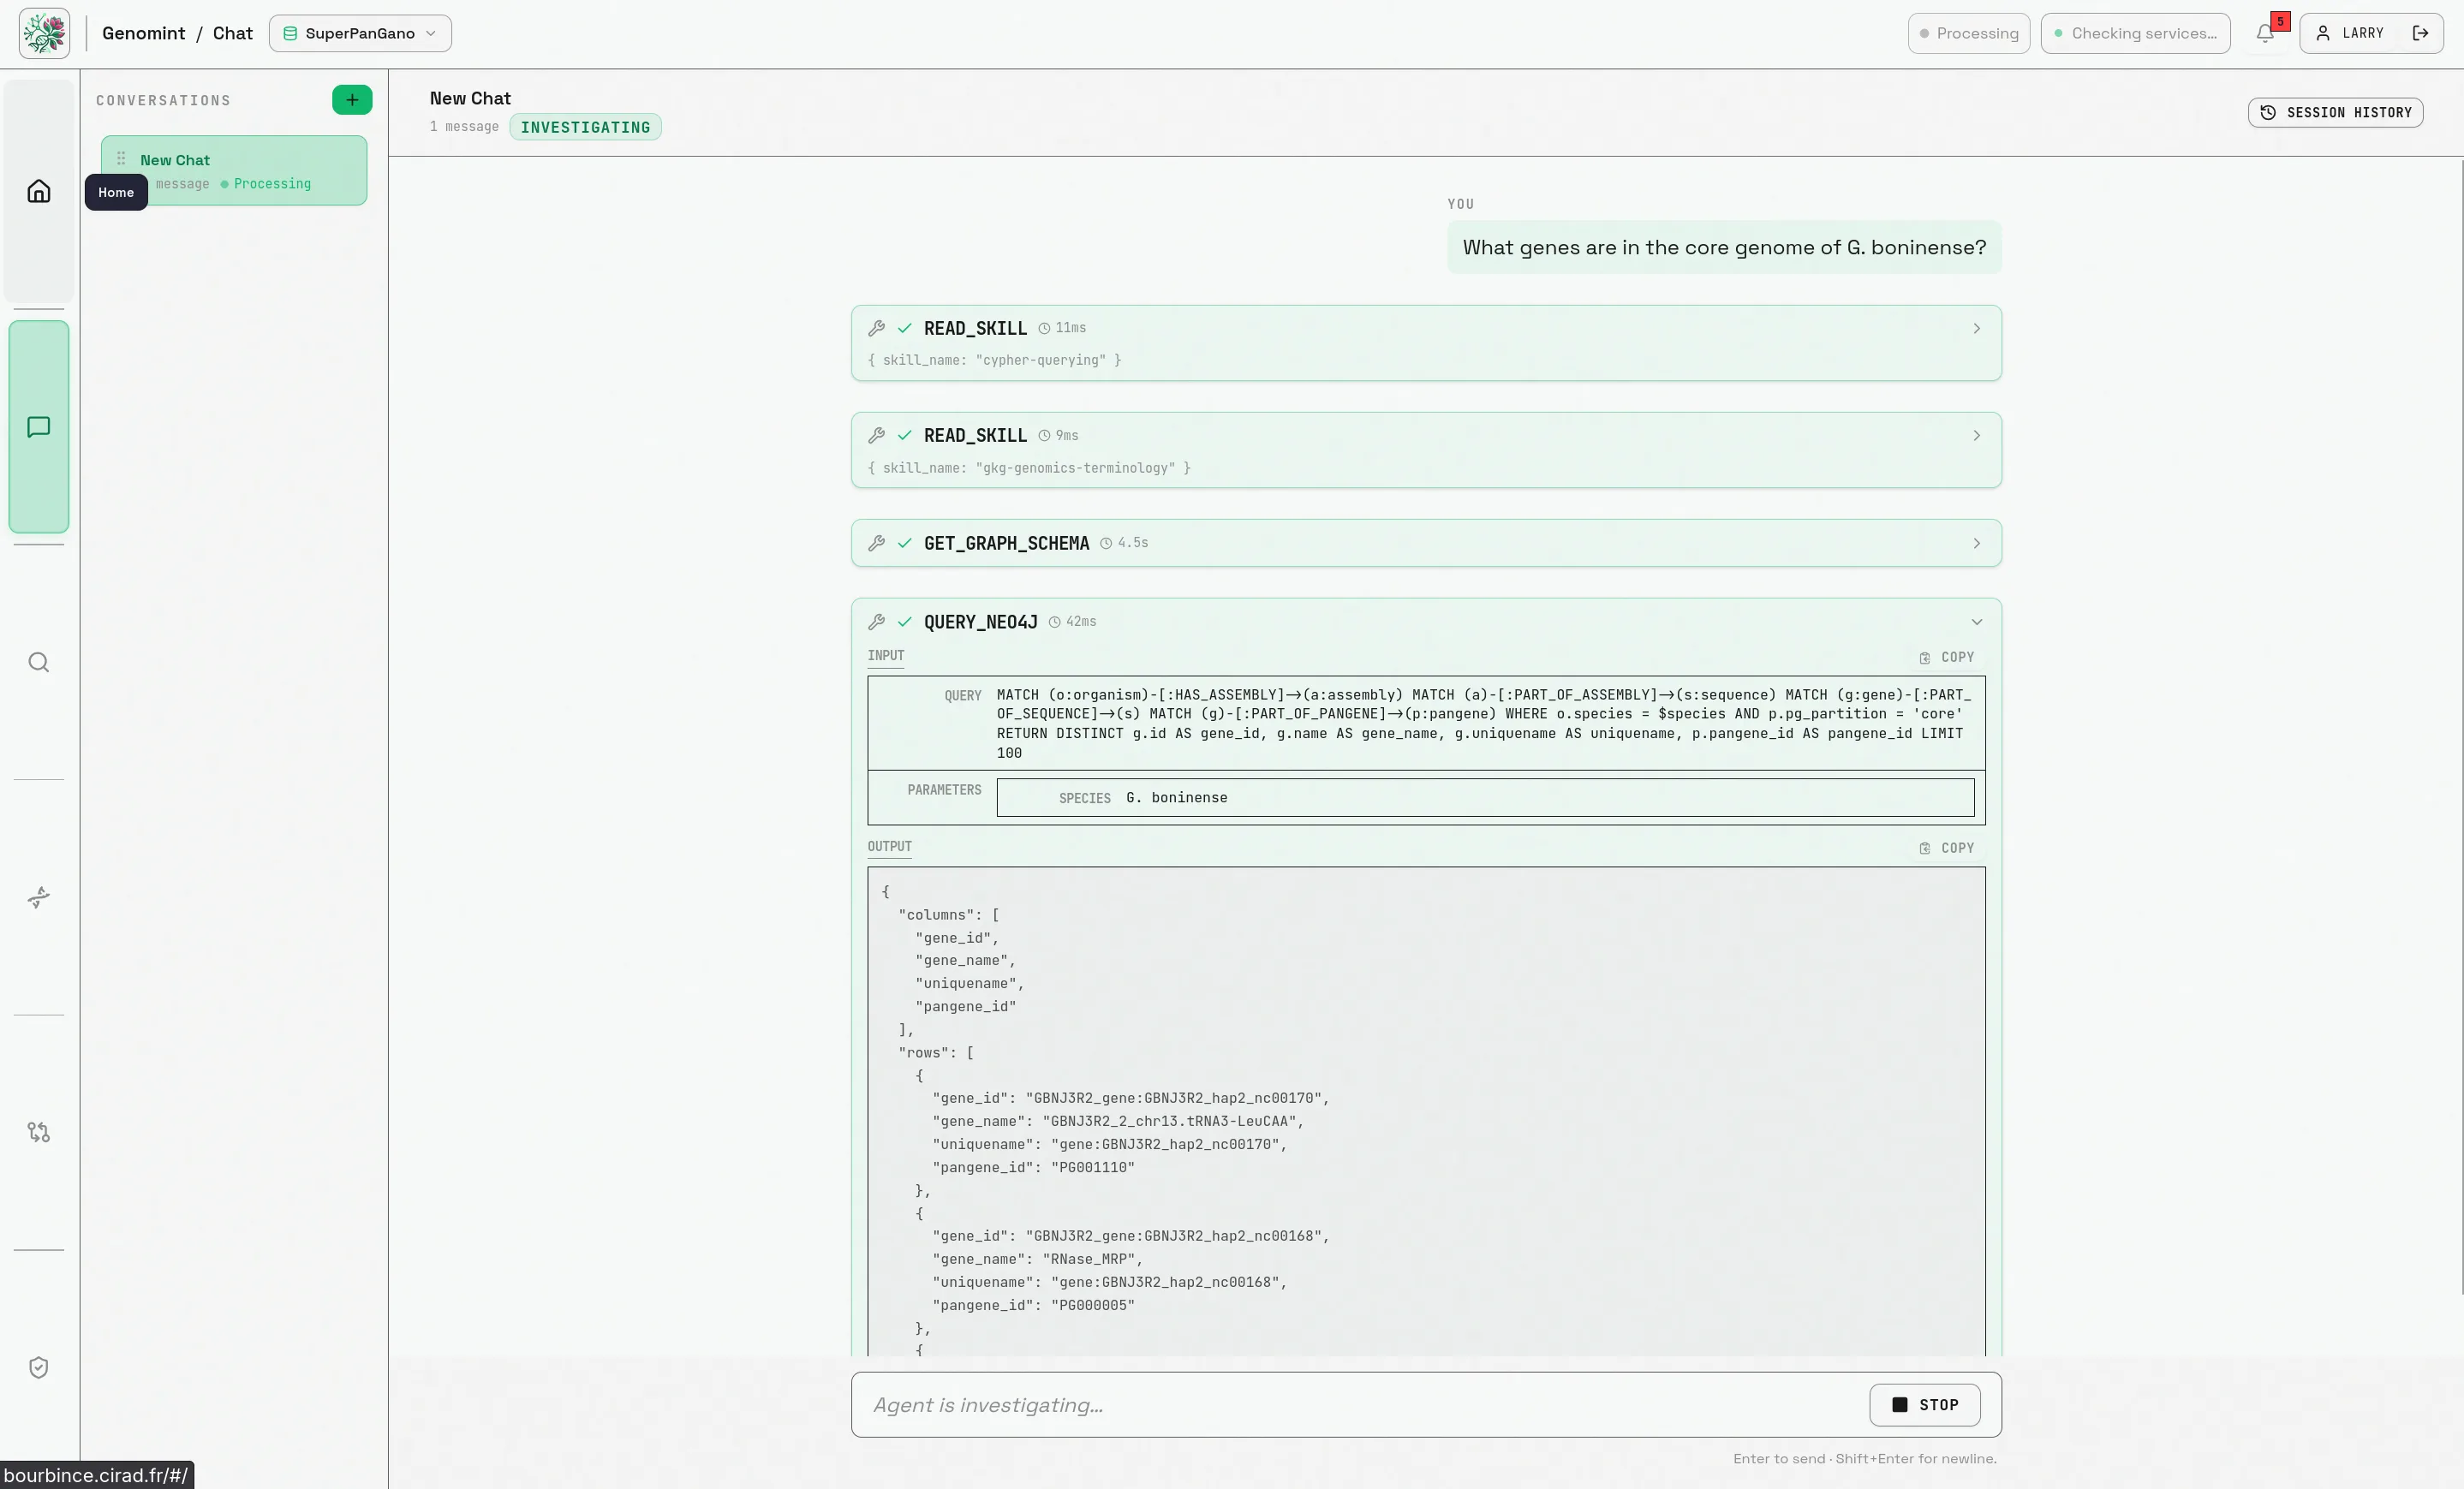
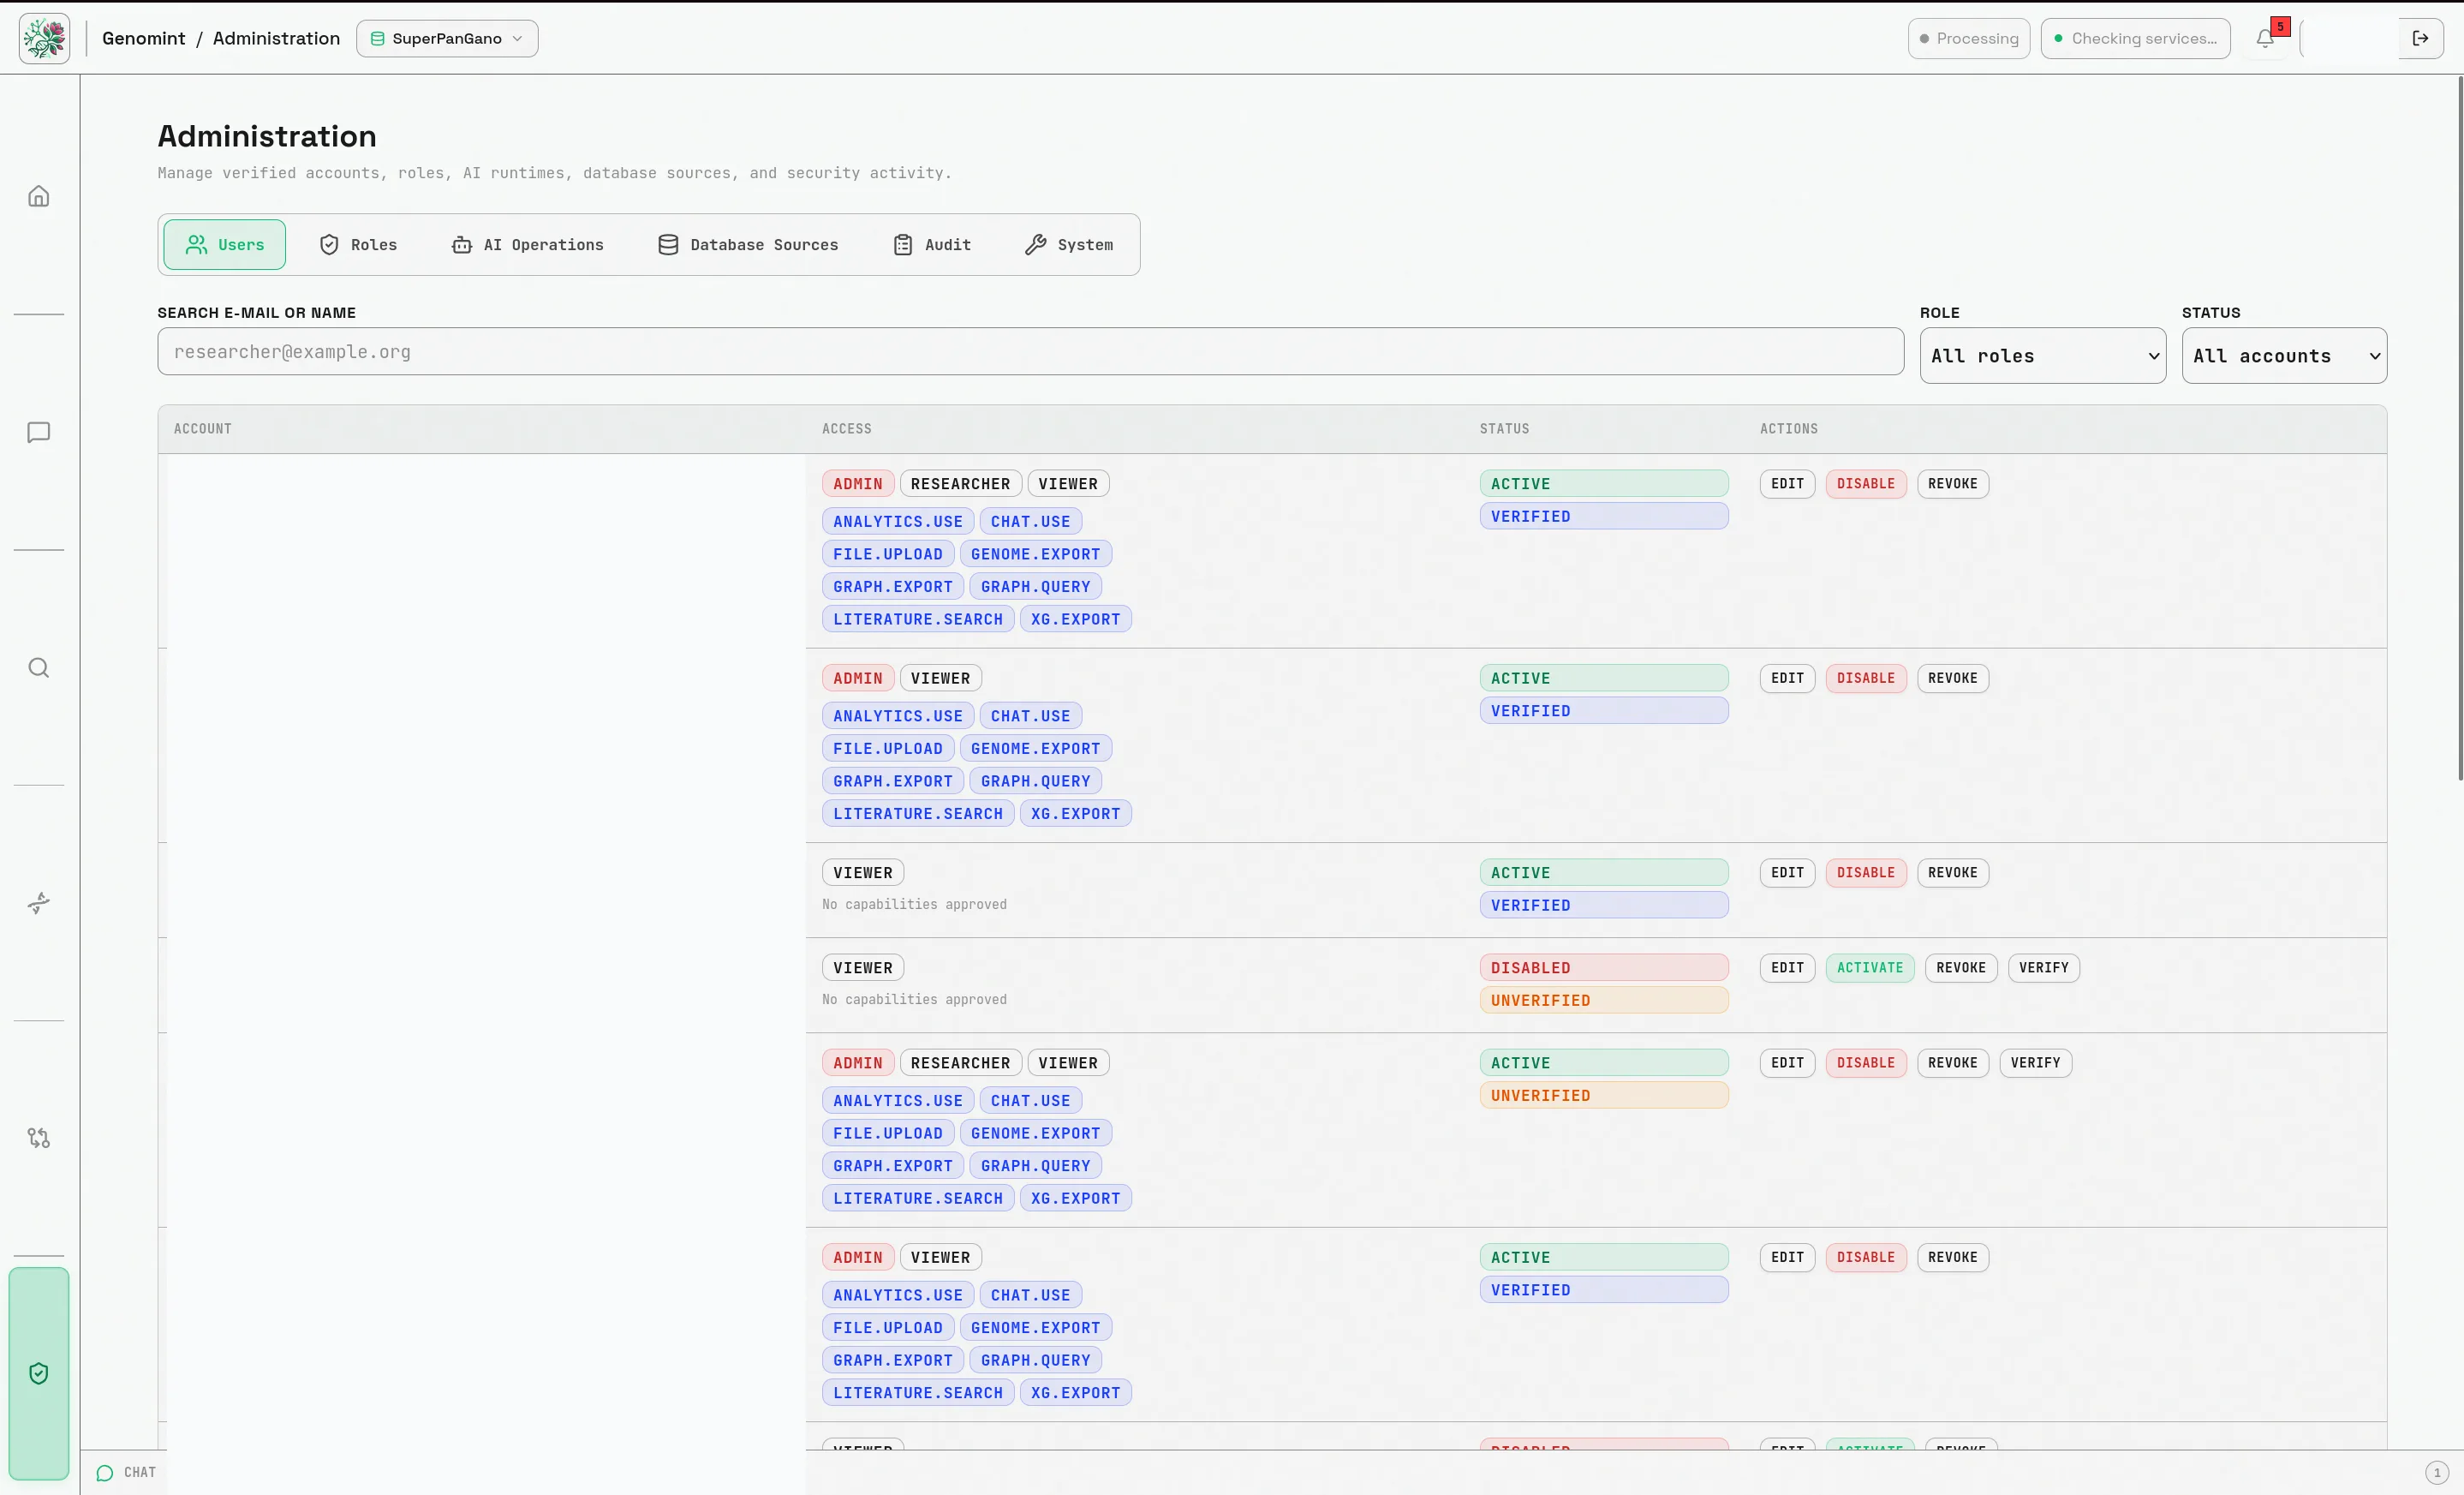
01 · Choisir la stratégie de retrieval
Pour le retrieval, j’ai comparé un RAG classique, où un index figé fournit un contexte unique avant la génération, et un RAG complètement agentique : le modèle décide lui-même des outils à appeler, itère et vérifie. Sur un graphe pangénomique, la comparaison a tranché : les réponses vivent dans le schéma et les traversées Cypher, pas dans des passages de texte. L’agent pilote donc GET_GRAPH_SCHEMA, READ_SKILL et QUERY_NEO4J au fil de la question.
Ce pilotage agentique est accompagné d’un petit système de RAG adapté aux données en graphe pangénomique : l’index vectoriel natif de Neo4j, utilisé en recherche hybride. Les descriptions de pangènes et les annotations sont plongées dans la base ; la similarité vectorielle retrouve les nœuds qu’une requête littérale aurait manqués, puis une à deux traversées les rattachent aux génomes, transcrits et annotations voisins.
La répartition reste stricte : le vecteur suggère, Cypher prouve. Les faits de séquence, comme la présence d’un pangène ou l’appartenance au core genome, sortent du graphe, jamais des paramètres du modèle.
- Compromis
- Le retrieval agentique coûte plus de tours d’outils et de tokens qu’un contexte pré-calculé ; en échange, chaque réponse reste traçable jusqu’aux nœuds du graphe.
02 · Servir l’explorateur et les exports
Pour le GKG Explorer, j’ai développé les requêtes et les API qui alimentent les filtres, le graphe et les résultats. Les filtres restent côté serveur ; la pagination précède l’enrichissement pour éviter de préparer un chromosome entier.
Pour les exports, les séquences sont résolues par lots, les segments FASTA respectent leur orientation et les états volumineux passent par SQLite ou JSONL avant la construction de l’archive.
- Limite
- Taille des lignes, tampons Neo4j et ZIP non bornés en octets : pic mémoire et tenue en charge à mesurer.
Pagination : moins de pages, pas un benchmark
Pour 15 615 segments, pages de 1 000 → 10 000.
Avant · 1 000 / page 16 pages Après · 10 000 / page 2 pages 14 requêtes de page en moins ; aucun gain de temps ou de mémoire mesuré.
03 · Encadrer Cypher
Le validateur normalise et tokenise Cypher, refuse les écritures et inspecte les sous-requêtes. QueryService ajoute lecture seule et délai ; le client ouvre une session Neo4j READ_ACCESS.
La route impose permissions et limitation de débit. Ces contrôles applicatifs ne prouvent pas que le compte Neo4j dispose des privilèges minimaux.
- Hors preuve
- Fuzzing adversarial, test d’intrusion et audit des privilèges Neo4j.
04 · Déployer et vérifier
Images Podman, registre OCI compatible, Helm et K3s. Un miroir local a contourné une incompatibilité de format avec le registre GitLab.
helm upgrade --install --atomic --wait, puis vérification des pods, services et routes protégées : une procédure reproductible, pas une garantie de disponibilité sous charge.
- À établir
- Reprise des flux entre réplicas, comportement sous charge et validation biologique.